

参考
架构
一个研究问题怎么变成排好序的论文、能读的正文和本地文献库。
# 架构 Scholar 把智能体的研究问题和论文、引用、全文以及本地文献库连起来。MCP 客户端、命令行和 Python 背后是同一个 Python 服务器。 <figure class="sc-demo" id="film"> <video controls preload="metadata" playsinline poster="/scholar-mcp/media/scholar-backend-poster.jpg"> <source src="/scholar-mcp/media/scholar-backend-film.mp4" type="video/mp4" /> </video> </figure> ## 检索 <Figure src={pipeline} dark={pipelineDark} alt="Scholar MCP 检索流程" width={720} /> 一次搜索分四步: 1. **分发问题。** 语义数据源按意思匹配,收到原句。关键词数据源按字面匹配,词越多越难命中,所以收到精简后的关键词,长度按每个数据源的实测最优值设定。 2. **同时搜。** 每个数据源有自己的一条队,同一数据源的多个查询按顺序、按它允许的节奏发,不同数据源之间并行。返回的都是同一种论文格式,排序前就能合并。先回来的数据源,在慢的还在搜时就开始补全信息。 3. **先排序,再扩展。** 第一轮排序挑出最相关的几篇做种子,再顺着它们的参考文献、被引和相关工作多找一轮。挑种子时还没回来的数据源不会被丢掉,回来后会在下一步并进来。 4. **整体重排。** 最后用一个排序模型一次给所有候选打分,不拿不同轮次、不同模型的分数取平均。筛选条件和条数限制要等整个候选池打完分才生效。 最终排序以模型给出的相关度为主,再参考引用数、被几个数据源共同找到和发表新旧,这些是排序信号,不是对论文好坏的评价。候选再多也不会被截掉,排序服务一次处理不完时分批打分,再统一排序。`sort` 用引用数或日期直接替换排序,`intent` 让排序和扩展偏向奠基工作、近期工作、综述、方法或数据集。 ## 认出同一篇论文 同一篇论文常从几个数据源带着不同的标识符回来。Scholar 先统一 DOI、arXiv 版本号和各种别名,按共同的标识符配对,再按完全一致且不矛盾的标题配对,然后合成一条,同时记住每个数据源各自找到了它。只有还没认出的记录,或筛选条件需要的字段,才会多查一次: - DOI 在 OpenAlex 批量查,Crossref 精确匹配做备选 - PMID 在 Europe PMC 批量查 - arXiv 查它自己的记录 - 只有引文文字的,做经过核对的书目匹配 arXiv 的 DOI 别名、作者对得上的重复提交,都不会让同一篇论文占好几个位置。补全信息的查询不算作多一个数据源的投票。 记录的标识、作者、版本和合并规则由独立的数据模块维护;排序与存储共用同一份规则。来源只返回实际支持的字段,未知值在公共输出处统一呈现。命令行与 MCP 也共用同一份文本序列化。 ## 数据源和模型 所有数据源登记在一张表中,写明各自的能力,包括搜索、单篇查询、被引、参考文献和查找 PDF。新增数据源无需新增 MCP 工具。Crossref 提供登记的参考文献,Europe PMC 提供引用关系,并能从开放全文中找回参考文献,INSPIRE-HEP 自带引用关系,它们与 Semantic Scholar、OpenAlex 汇成同一张图。 数据源运行在一个固定大小的共享线程池中,请求失败与搜到零条分开记录。排序模型返回的分数先经校验,合格才采用。云端 Qwen、兼容的自定义服务和本地 FlashRank 共用同一套请求、分批和分数校验。远程服务连不上时停用五分钟,期间由本地模型排序,见[配置](/scholar-mcp/zh-cn/configuration/#排序模型)。 ## 运行时 <Figure src={runtime} dark={runtimeDark} alt="Scholar MCP 运行时架构" width={720} /> 本机的客户端通过 stdio 连接 Scholar,也就是客户端自己启动这个程序,再经标准输入输出和它对话,不占网络端口。客户端不能自己启动程序时(比如网页里的智能体,或几个人共用一台服务器),Scholar 可以作为网络服务运行,客户端用 Streamable HTTP 连过来。本地的 SQLite 文献库负责全文搜索、PDF 附件、JSONL 快照,以及 Obsidian、Zotero 和 Notion 连接器。 工具返回普通数据,到 MCP 出口才统一渲染一次,生成一份 YAML 文本(多行段落用字面块)和一份结构化内容。命令行和 Python 拿到的是同样的字典。任一工具给出的标识符、论文链接或准确标题,其他工具都能识别。阅读和下载先使用最近结果中合并好的记录,找不到时才重新查询。 ## 读论文和存论文 `read_paper` 复用已保留的 PDF,或在读完后清理本次临时下载。默认返回第 1 到 10 页按页标注的 Markdown,每次最多 100,000 字,因此常见的十页会完整返回。更长的范围在页边界停下,并给出 `next_pages`。它会告诉 Claude Code 自己的结果有多大,所以 Claude Code 完整保留。Codex 会把过长的结果从中间截掉,所以在 Codex 里每次读到约 36,000 字就停下,并给出 `next_pages`。指定页码能读到后面的章节,图、表和页面的名字能取回那一块的截图。识别得出的表格以结构化文本返回。 `download_paper` 把 PDF 存进论文目录,并记进文献库的一个集合。几个候选位置同时试,PDF 先在临时文件里确认完整,才移到正式位置。返回完整路径,下次会话换了工作目录也找得到。有可靠关系的预印本和正式版共享作品身份,优先采用可取得的正式版。升级时使用独立的版本和内容哈希文件名,保留旧 PDF 和其中的批注。 文献库的记录存放在支持全文搜索的 SQLite 中,JSONL 用于迁移和快照,PDF 和 Markdown 仓库为独立文件。记录保留完整的作者和摘要,连接器仅在你要求时导出或同步。 ## 健康检查 二十多个外部接口随时可能改版、限流或停服,所以 Scholar 自己盯着每条链路。每次调用工具都会在本地留下一行简短记录,不含问题本身,只记耗时、各数据源的回应、用了哪个排序模型以及 PDF 从哪里来。`scholar-mcp doctor` 读这份记录,拿每个数据源和它自己过去的表现比,指出开始报错、突然没有结果、丢了摘要或明显变慢的那个。`doctor --network` 会直接探测最近没被真实使用验证过的免费链路,仓库每天也会自动跑一遍,见[命令行](/scholar-mcp/zh-cn/cli/#doctor)。 ## 代码地图 | 模块 | 职责 | |---|---| | `server.py` | 工具实现、流程编排、标识符解析和 MCP 出口 | | `api.py`、`cli.py` | 基于同一组函数的 Python API 和命令行 | | `install.py` | 注册客户端,带备份、安全写入和所写条目的记录 | | `sources/` | 数据源登记、按源排队和查询路由,每家接口一个模块 | | `relevance.py`、`expansion.py` | 查询准备、合并同一篇论文、排序和引用扩展 | | `metadata.py` | 补全信息不全的记录 | | `traversal.py`、`graph.py` | 引用关系和图谱构建 | | `pdf_utils.py`、`paper_reader.py` | 找 PDF、结构化阅读和图像 | | `scholar_session.py` | Google 验证与会话状态 | | `credentials.py` | 文献库连接器的系统凭据存储 | | `knowledge_base.py`、`library_store.py` | 文献库的记录和搜索 | | `vault.py`、`library_connectors.py` | 导出和同步到外部文献库 | | `usage_log.py`、`health.py` | 本地调用记录、问题发现和实时探测 | | `config.py`、`cache.py` | 配置、密钥文件和响应缓存 |Scholar 把智能体的研究问题和论文、引用、全文以及本地文献库连起来。MCP 客户端、命令行和 Python 背后是同一个 Python 服务器。
检索
“检索”一节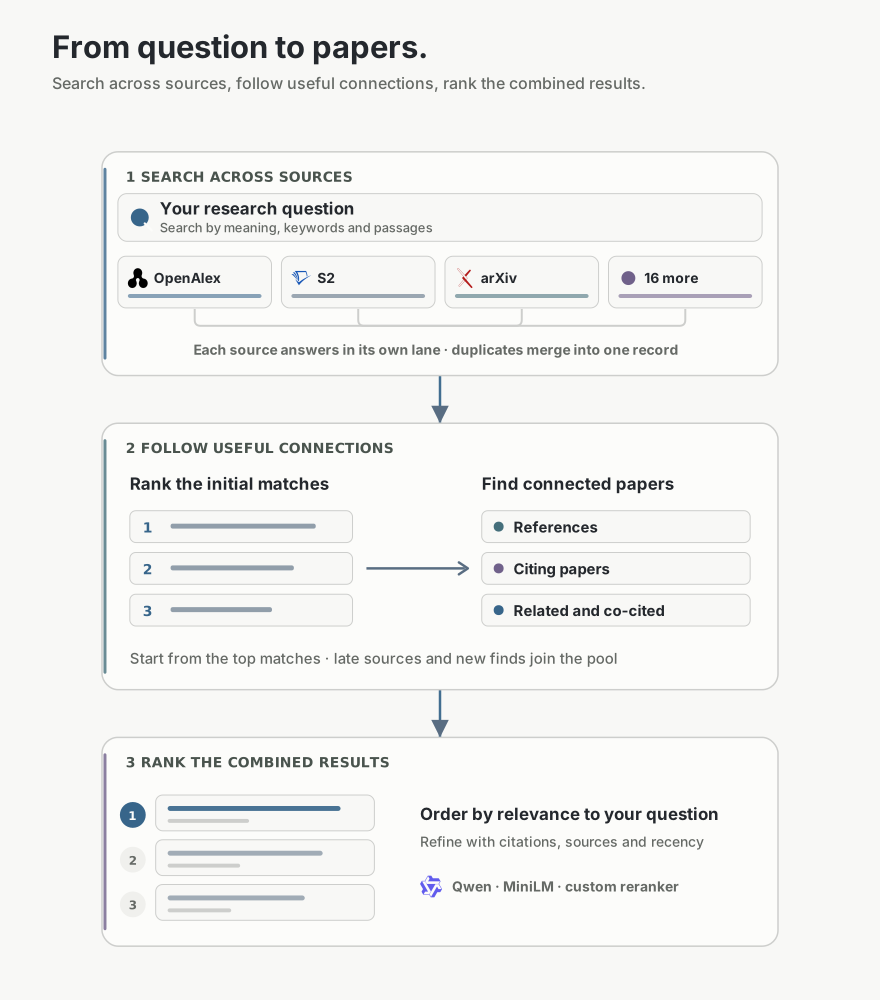
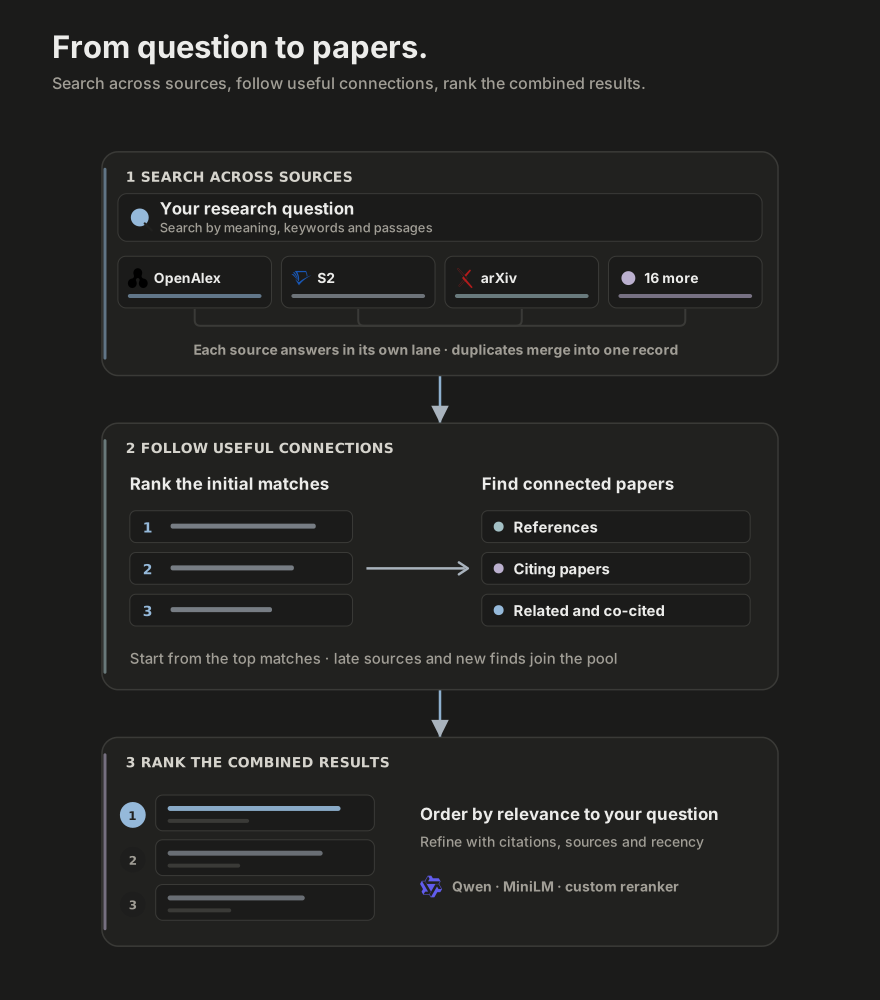
一次搜索分四步:
- 分发问题。 语义数据源按意思匹配,收到原句。关键词数据源按字面匹配,词越多越难命中,所以收到精简后的关键词,长度按每个数据源的实测最优值设定。
- 同时搜。 每个数据源有自己的一条队,同一数据源的多个查询按顺序、按它允许的节奏发,不同数据源之间并行。返回的都是同一种论文格式,排序前就能合并。先回来的数据源,在慢的还在搜时就开始补全信息。
- 先排序,再扩展。 第一轮排序挑出最相关的几篇做种子,再顺着它们的参考文献、被引和相关工作多找一轮。挑种子时还没回来的数据源不会被丢掉,回来后会在下一步并进来。
- 整体重排。 最后用一个排序模型一次给所有候选打分,不拿不同轮次、不同模型的分数取平均。筛选条件和条数限制要等整个候选池打完分才生效。
最终排序以模型给出的相关度为主,再参考引用数、被几个数据源共同找到和发表新旧,这些是排序信号,不是对论文好坏的评价。候选再多也不会被截掉,排序服务一次处理不完时分批打分,再统一排序。sort 用引用数或日期直接替换排序,intent 让排序和扩展偏向奠基工作、近期工作、综述、方法或数据集。
认出同一篇论文
“认出同一篇论文”一节同一篇论文常从几个数据源带着不同的标识符回来。Scholar 先统一 DOI、arXiv 版本号和各种别名,按共同的标识符配对,再按完全一致且不矛盾的标题配对,然后合成一条,同时记住每个数据源各自找到了它。只有还没认出的记录,或筛选条件需要的字段,才会多查一次:
- DOI 在 OpenAlex 批量查,Crossref 精确匹配做备选
- PMID 在 Europe PMC 批量查
- arXiv 查它自己的记录
- 只有引文文字的,做经过核对的书目匹配
arXiv 的 DOI 别名、作者对得上的重复提交,都不会让同一篇论文占好几个位置。补全信息的查询不算作多一个数据源的投票。
记录的标识、作者、版本和合并规则由独立的数据模块维护;排序与存储共用同一份规则。来源只返回实际支持的字段,未知值在公共输出处统一呈现。命令行与 MCP 也共用同一份文本序列化。
数据源和模型
“数据源和模型”一节所有数据源登记在一张表中,写明各自的能力,包括搜索、单篇查询、被引、参考文献和查找 PDF。新增数据源无需新增 MCP 工具。Crossref 提供登记的参考文献,Europe PMC 提供引用关系,并能从开放全文中找回参考文献,INSPIRE-HEP 自带引用关系,它们与 Semantic Scholar、OpenAlex 汇成同一张图。
数据源运行在一个固定大小的共享线程池中,请求失败与搜到零条分开记录。排序模型返回的分数先经校验,合格才采用。云端 Qwen、兼容的自定义服务和本地 FlashRank 共用同一套请求、分批和分数校验。远程服务连不上时停用五分钟,期间由本地模型排序,见配置。
运行时
“运行时”一节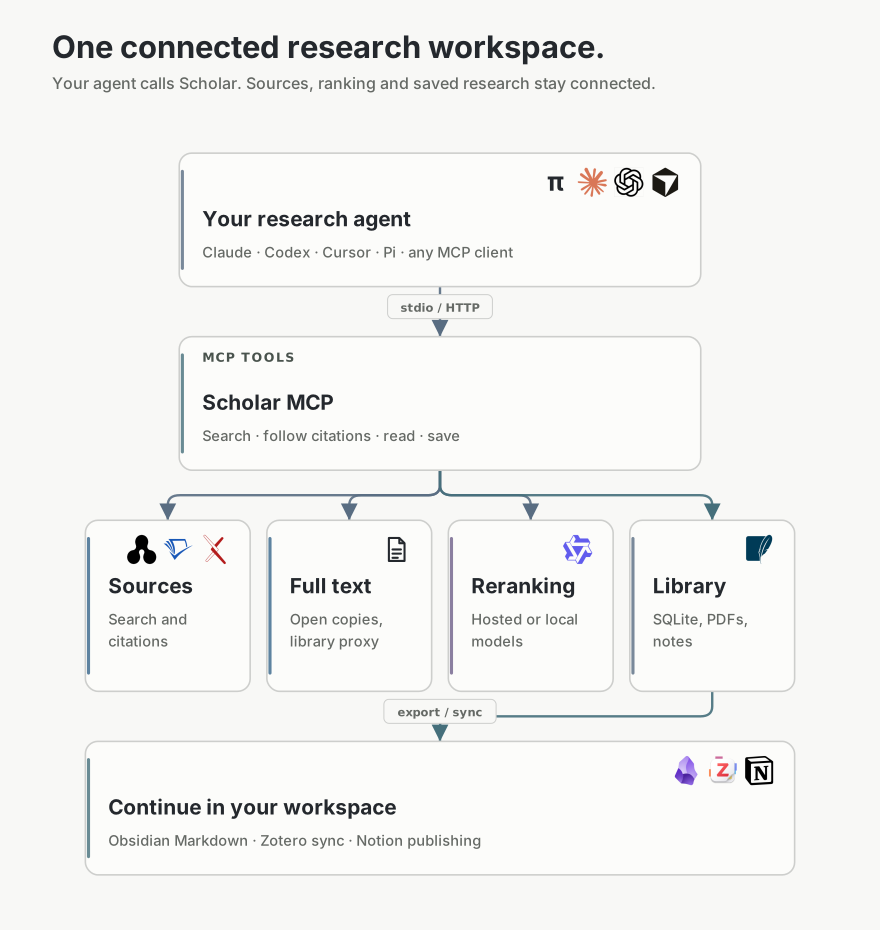
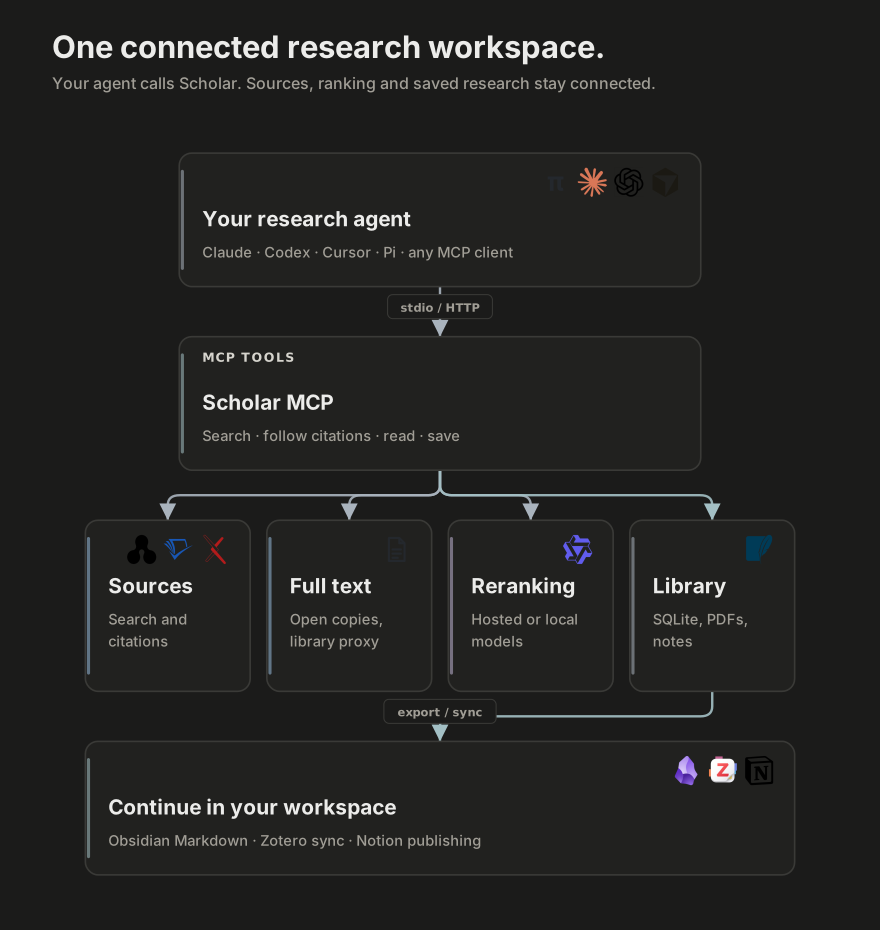
本机的客户端通过 stdio 连接 Scholar,也就是客户端自己启动这个程序,再经标准输入输出和它对话,不占网络端口。客户端不能自己启动程序时(比如网页里的智能体,或几个人共用一台服务器),Scholar 可以作为网络服务运行,客户端用 Streamable HTTP 连过来。本地的 SQLite 文献库负责全文搜索、PDF 附件、JSONL 快照,以及 Obsidian、Zotero 和 Notion 连接器。
工具返回普通数据,到 MCP 出口才统一渲染一次,生成一份 YAML 文本(多行段落用字面块)和一份结构化内容。命令行和 Python 拿到的是同样的字典。任一工具给出的标识符、论文链接或准确标题,其他工具都能识别。阅读和下载先使用最近结果中合并好的记录,找不到时才重新查询。
读论文和存论文
“读论文和存论文”一节read_paper 复用已保留的 PDF,或在读完后清理本次临时下载。默认返回第 1 到 10 页按页标注的 Markdown,每次最多 100,000 字,因此常见的十页会完整返回。更长的范围在页边界停下,并给出 next_pages。它会告诉 Claude Code 自己的结果有多大,所以 Claude Code 完整保留。Codex 会把过长的结果从中间截掉,所以在 Codex 里每次读到约 36,000 字就停下,并给出 next_pages。指定页码能读到后面的章节,图、表和页面的名字能取回那一块的截图。识别得出的表格以结构化文本返回。
download_paper 把 PDF 存进论文目录,并记进文献库的一个集合。几个候选位置同时试,PDF 先在临时文件里确认完整,才移到正式位置。返回完整路径,下次会话换了工作目录也找得到。有可靠关系的预印本和正式版共享作品身份,优先采用可取得的正式版。升级时使用独立的版本和内容哈希文件名,保留旧 PDF 和其中的批注。
文献库的记录存放在支持全文搜索的 SQLite 中,JSONL 用于迁移和快照,PDF 和 Markdown 仓库为独立文件。记录保留完整的作者和摘要,连接器仅在你要求时导出或同步。
健康检查
“健康检查”一节二十多个外部接口随时可能改版、限流或停服,所以 Scholar 自己盯着每条链路。每次调用工具都会在本地留下一行简短记录,不含问题本身,只记耗时、各数据源的回应、用了哪个排序模型以及 PDF 从哪里来。scholar-mcp doctor 读这份记录,拿每个数据源和它自己过去的表现比,指出开始报错、突然没有结果、丢了摘要或明显变慢的那个。doctor --network 会直接探测最近没被真实使用验证过的免费链路,仓库每天也会自动跑一遍,见命令行。
代码地图
“代码地图”一节| 模块 | 职责 |
|---|---|
server.py |
工具实现、流程编排、标识符解析和 MCP 出口 |
api.py、cli.py |
基于同一组函数的 Python API 和命令行 |
install.py |
注册客户端,带备份、安全写入和所写条目的记录 |
sources/ |
数据源登记、按源排队和查询路由,每家接口一个模块 |
relevance.py、expansion.py |
查询准备、合并同一篇论文、排序和引用扩展 |
metadata.py |
补全信息不全的记录 |
traversal.py、graph.py |
引用关系和图谱构建 |
pdf_utils.py、paper_reader.py |
找 PDF、结构化阅读和图像 |
scholar_session.py |
Google 验证与会话状态 |
credentials.py |
文献库连接器的系统凭据存储 |
knowledge_base.py、library_store.py |
文献库的记录和搜索 |
vault.py、library_connectors.py |
导出和同步到外部文献库 |
usage_log.py、health.py |
本地调用记录、问题发现和实时探测 |
config.py、cache.py |
配置、密钥文件和响应缓存 |